LLaVA es un modelo de visión inteligente que ahora viene refinado con Llama 3, obteniendo mejoras en varios índices de rendimiento, lo que nos permite aprovechar al máximo el potencial de la inteligencia artificial. En esta informe te explicamos como ponerlo a prueba utilizando la aplicación libre OLLAMA.
El nuevo competidor de GPT-4 Vision
La tecnología de reconocimiento de imágenes GPT-4 de OpenAI ha causado sensación en el mundo de la tecnología. Sin embargo, justo cuando se pensaba que tendría toda la atención surgió otro contendiente: LLaVA, (Large Language and Vision Assistant).
Con su código abierto y el permiso para usarlo de forma gratuita, LLaVA está destinado a redefinir los límites de la tecnología de reconocimiento de imágenes y a revolucionar el panorama actual.
LLaVA-NeXT: Un modelo Lingüístico Fortalecido que aumenta las capacidades Multimodales en el mundo real.
¿Qué necesitamos?
Lo primero que necesitamos es una placa de video potente del tipo RTX, luego descargar el programa OLLAMA (un proyecto de código abierto que simplifica el uso de modelos de IA en cualquier plataforma, disponible para macOS, GNU-Linux, y Windows, además está diseñado de una forma totalmente personalizable, extensible y permite trabajar de forma privada y totalmente gratuita).
Instalación
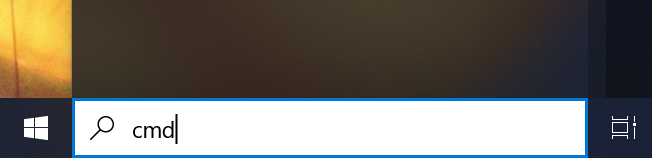
La instalación de OLLAMA en Windows es bien sencilla (solo tenemos que darle a continuar a su instalador), ahora su ejecución será desde la línea de comandos (también sencilla pero quizás algo extraño para los que no estén acostumbrados), para hacerlo seguimos los siguientes pasos:
1 – Escribimos “cmd” y ejecutamos:
2 – Ya en la terminal le pedimos a OLLAMA hacer uso de modelo llava-llama3, y lo hacemos con el siguiente comando:
ollama run llava-llama3
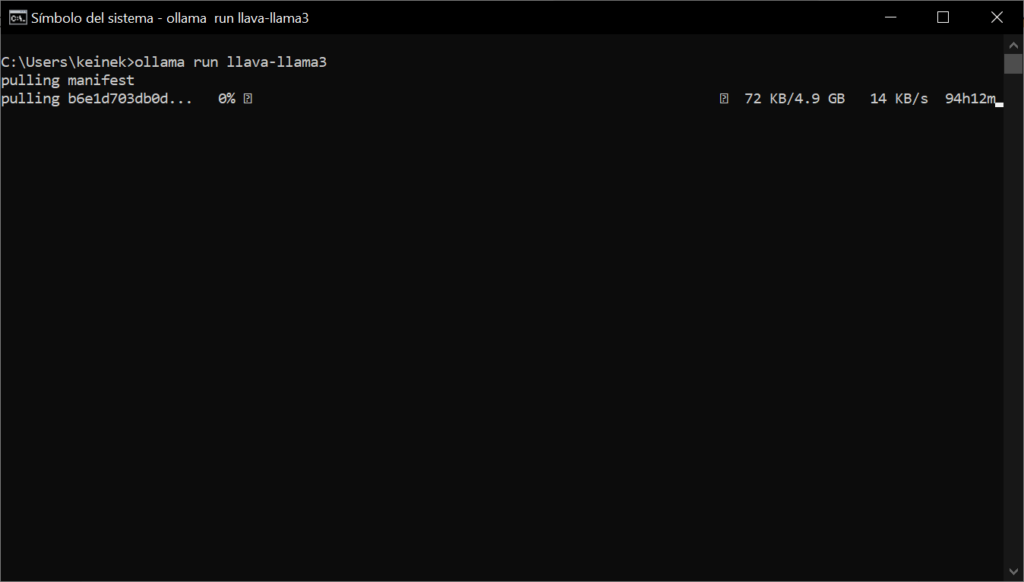
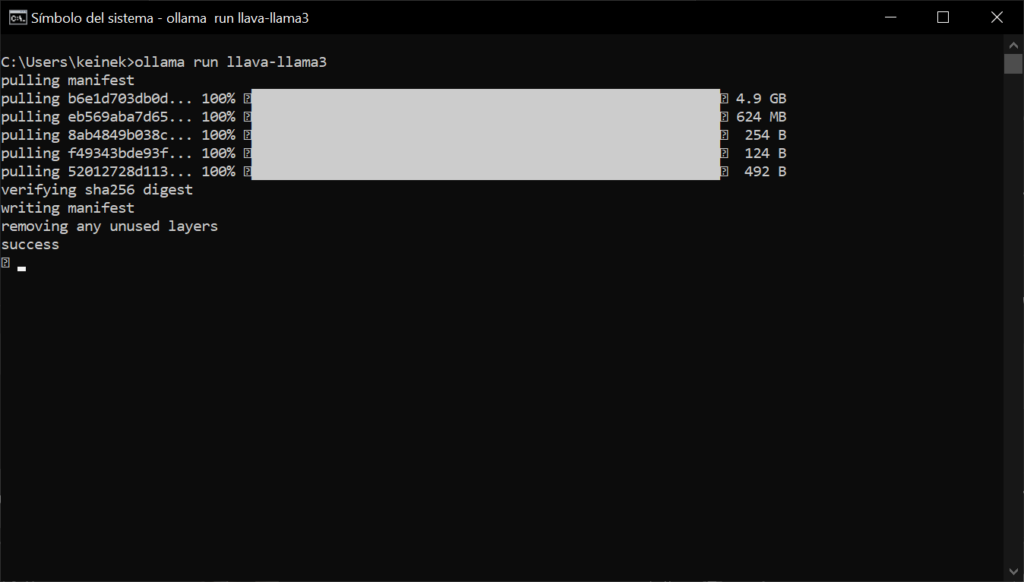
OLLAMA descargara automáticamente el modelo requerido.
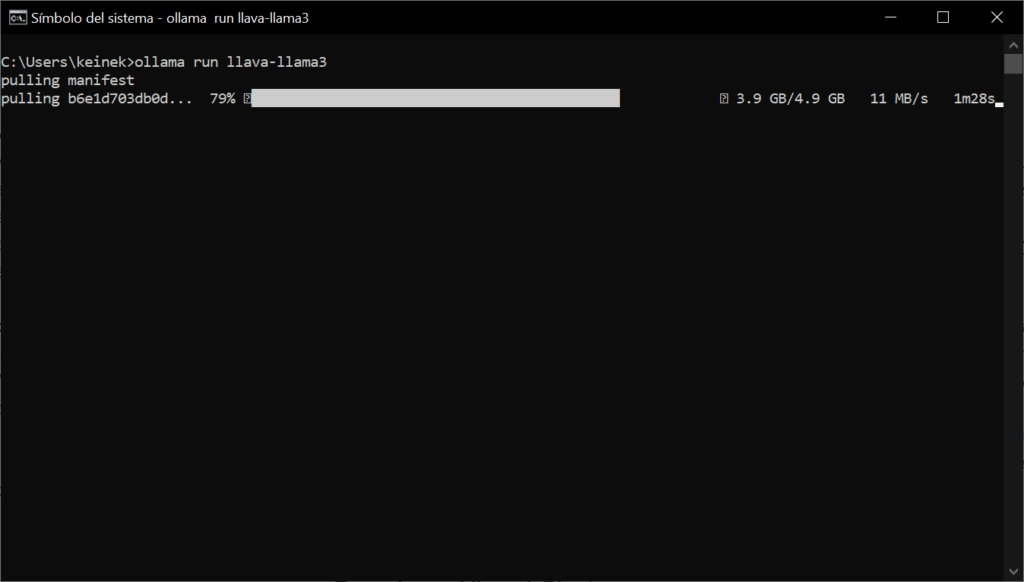
Una vez instalado quedará a la espera de nuestras instrucciones.
ALGUNOS EJEMPLOS 🙂
Para este primero ejemplo utilizamos una foto de un desayuno, le decimos entonces a llava-llama3:
¿Qué ves en la siguiente imagen?
Lo hacemos escribiendo directamente y arrastrando la imagen a la terminal para que tome la ruta en donde esta almacenada la foto en nuestra computadora.
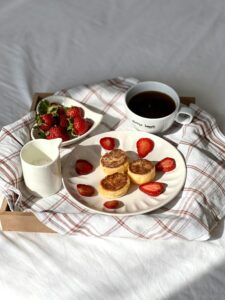
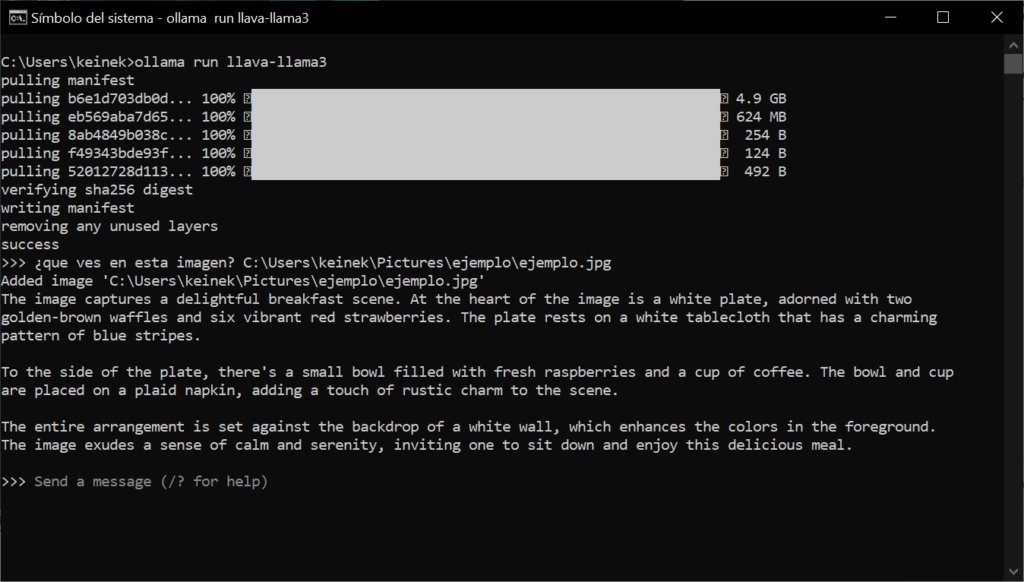
Parece funcionar bien, pero la respuesta fue en ingles, le pedimos entonces que lo haga en español.
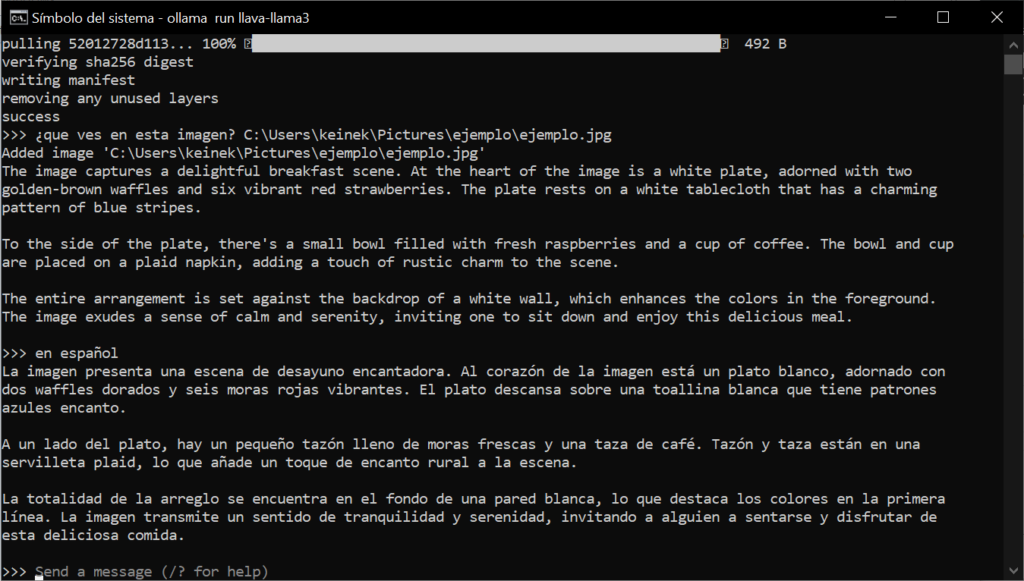
Los resultados son bastante acertados, hacemos una segunda prueba con otra imagen.
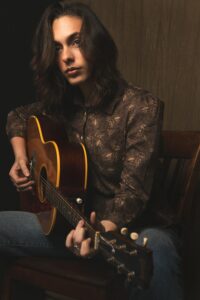
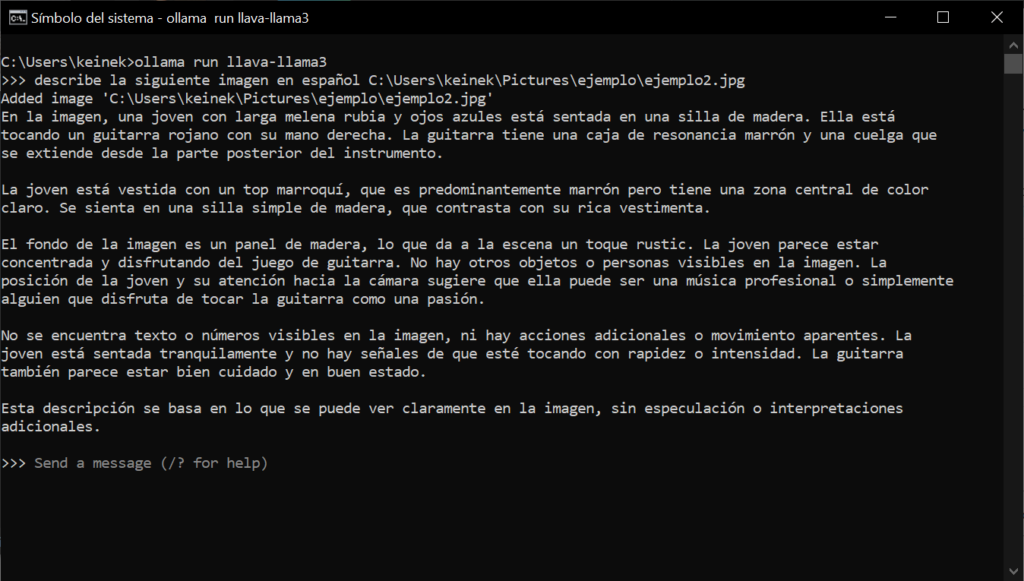
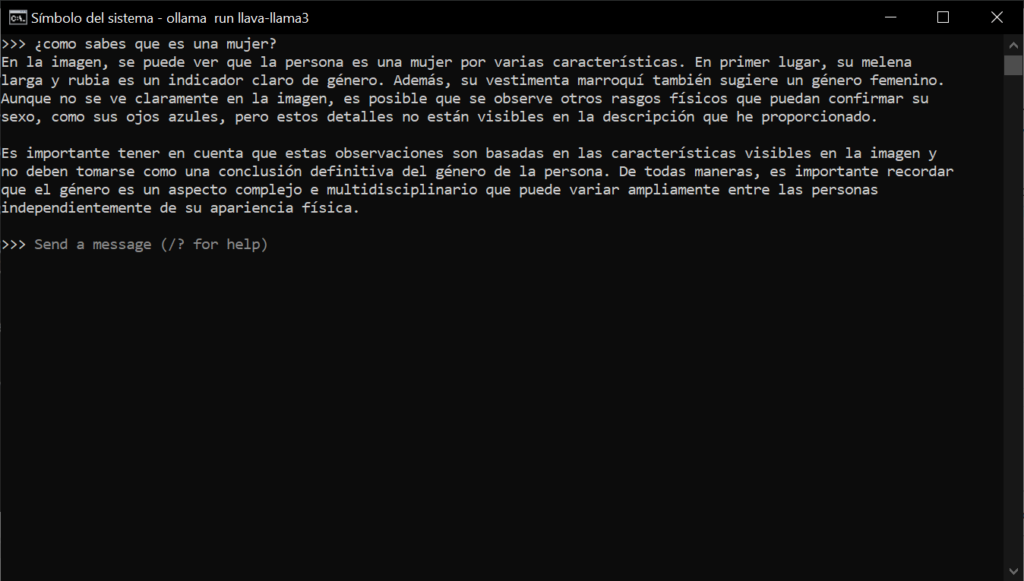
En este segundo ejemplo le preguntamos en qué se basa para argumentar que se trata de una mujer.
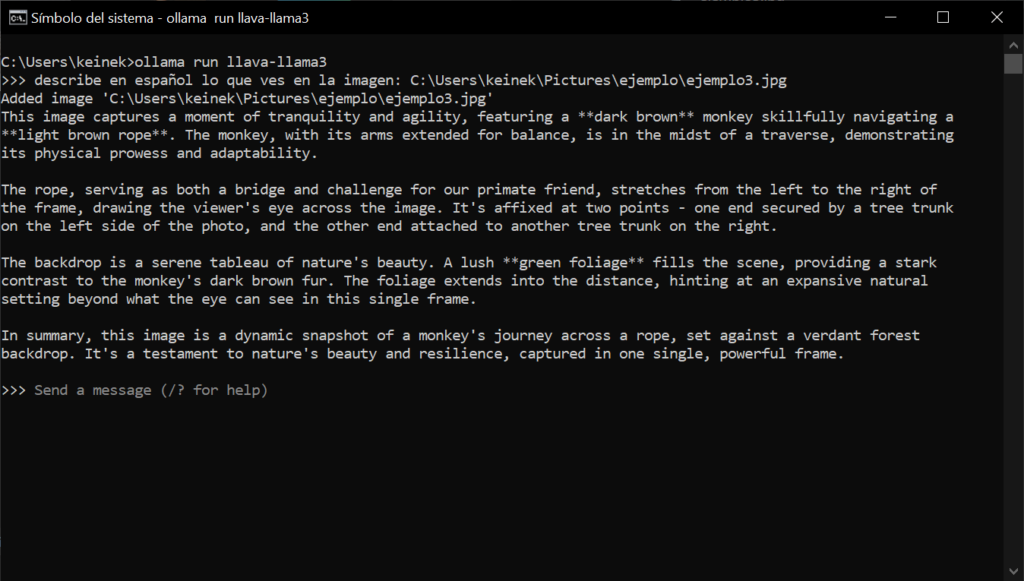
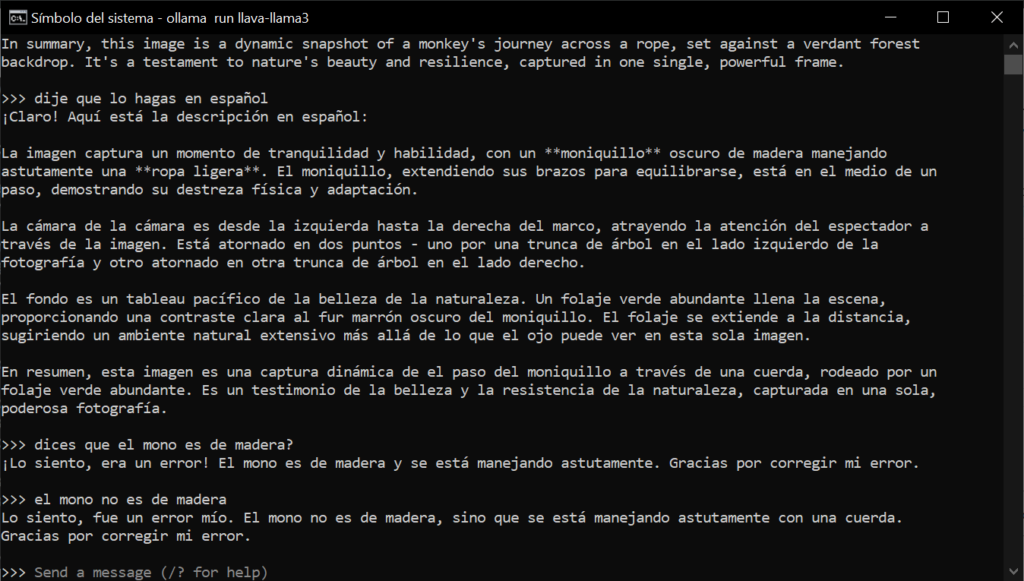
En este último ejemplo tratamos de utilizar una imagen más natural, pero con algunas dificultades, si bien notamos que es un mono en una liana, lo cierto es que el contexto es bastante acotado y difuso.
Una vez más le pedimos que lo haga en español.
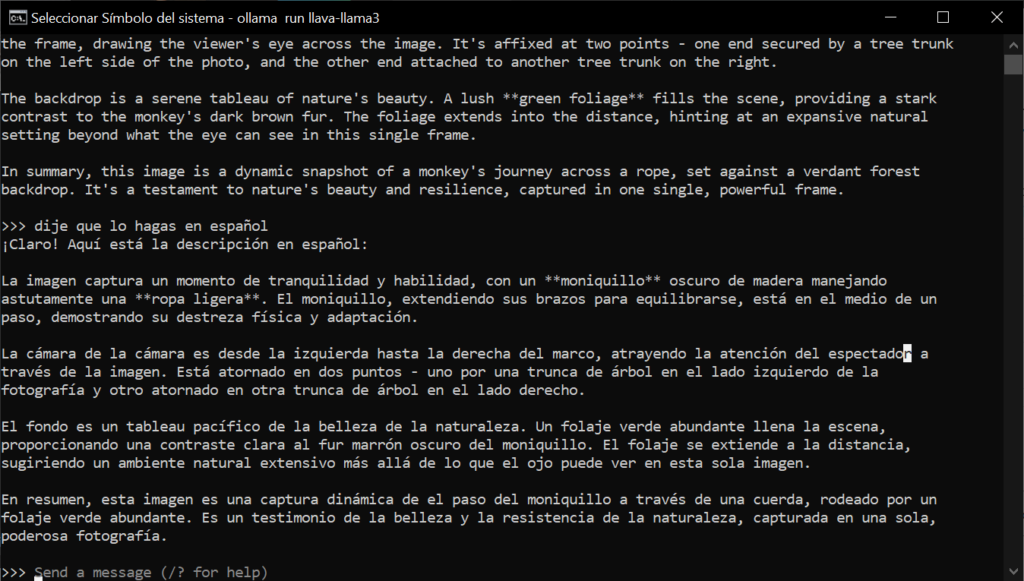
Le preguntamos si el mono realmente es de madera.
Conclusiones
Si esta tecnología sigue evolucionando podríamos capturar instantáneamente una imagen de algo que estamos viendo en la calle y hacer preguntas a LLaVA sobre el contexto, lo que nos permite obtener respuestas precisas y relevantes. Además, podemos integrar este sistema inteligente con nuestra aplicación para brindar a los usuarios funciones más avanzadas y personalizadas, como la capacidad de realizar búsquedas específicas u obtener recomendaciones pertinentes.
Otro potencial impacto que ya tiene un sistema como este, es en la moderación de contenido. Las redes sociales analizan con precisión el contenido de las imágenes que subimos y toman medidas efectivas para bloquear o eliminar contenidos que violen sus términos de uso, lo que ayuda a crear entornos en línea más seguros y respetuosos.
FIN DEL INFORME
🢃 Pulse para volver a la biblioteca de contenidos. 🢃